資料安全與 AI
說明雲端、本地端與混合部署的取捨,以及權限、操作紀錄與敏感資料的處理原則。
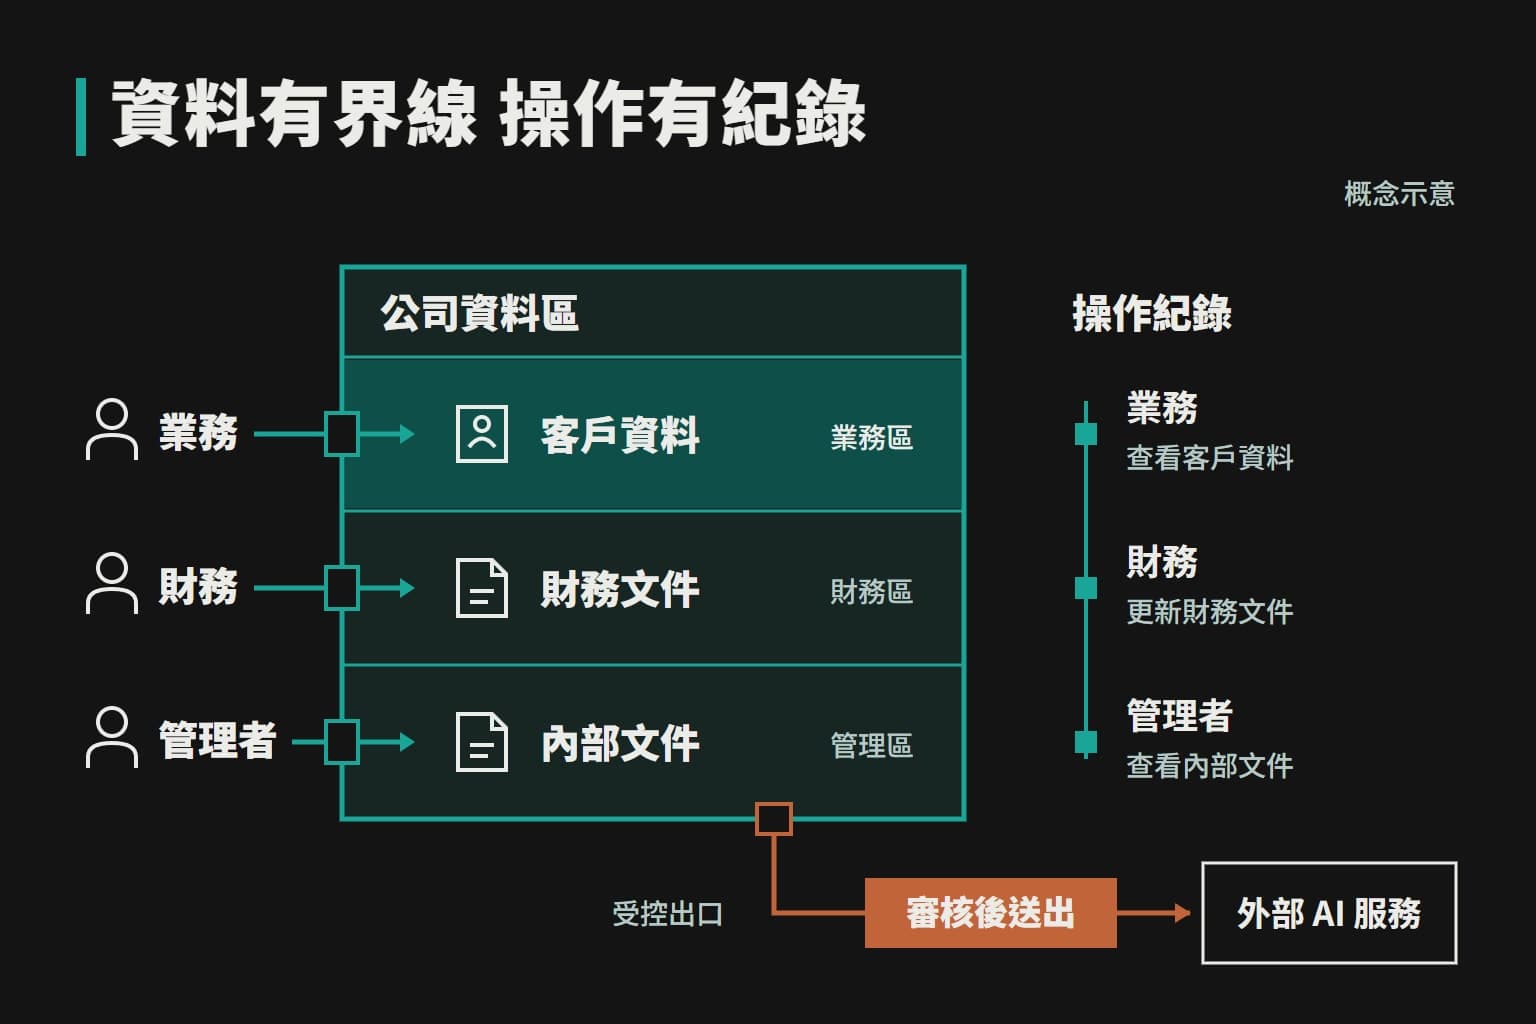
使用雲端 AI 時資料的去向
使用雲端 AI 時,送出的內容會傳到模型服務商的伺服器處理,再將結果傳回,資料會暫時離開公司。OpenAI 等大型服務商的企業 API 預設不以資料訓練模型,這與一般免費聊天服務的條件不同。但服務商仍可能為安全監控保存資料一段時間,實際條件應以各家當時的條款為準。
因此,雲端並非完全沒有風險,應依資料敏感程度決定使用方式。一般資料使用企業 API 多半可以接受;高度敏感的資料,可以先移除不必要的部分,或改用本地端處理。
本地端不一定比較好
本地端的優點是資料留在公司內、沒有依用量計算的模型費用,也不受外部服務條款變動影響。
需要考慮的限制
- 需要先購置設備
- 可在一般設備上運行的模型,能力通常低於雲端最強模型,在複雜判斷與長文件上尤其明顯
- 使用人數增加時速度會下降
- 設備維護、模型更新與資料備份都需要有人負責
- 設備放在公司內不等於自動安全,門禁、權限與備份同樣要做好
一般資料通常以雲端較划算,也能較快開始。病歷、客戶機密與未公開研發資料等,則值得考慮本地端或混合方式。
混合部署
混合部署是將敏感工作留在公司內處理,其他工作使用雲端。例如內部機密文件問答使用本地端模型,對外文案與公開資料整理則使用能力較強的雲端模型。
| 雲端 | 本地端 | 混合 | |
|---|---|---|---|
| 資料 | 傳到服務商的伺服器處理,暫時離開公司 | 留在公司內 | 敏感工作留在公司內,其他使用雲端 |
| 費用 | 依用量計費 | 先購置設備,沒有依用量計算的模型費用 | 兩者皆有 |
| 模型能力 | 可使用最強的模型 | 通常低於雲端最強模型 | 依工作選用 |
| 適合 | 一般資料,也能較快開始 | 病歷、客戶機密與未公開研發資料等 | 同時有敏感與一般工作 |
另一種做法是在送出前先移除敏感資料。以畢克森後台處理外包勞報單為例:
AI 取得
- 姓名
- 金額
不會傳給模型
- 身分證字號
- 銀行帳號
- 電話
- 地址
在考慮購置設備之前,可以先確認 AI 是否真的需要看到這些資料。
權限與操作紀錄
AI 的權限應與使用者相同
例如業務沒有查看財務資料的權限,透過 AI 也應查詢不到。這項限制要由系統權限執行,而不是僅以提示要求 AI 不要回答,因為提示可能被各種問法繞過。導入前應先確認公司目前的權限是否清楚;若所有資料都放在人人可讀的資料夾,應先行整理。
紀錄與回復
完善的系統應記錄 AI 查詢的內容、提出的建議,以及由誰按下確認。
通常可以修正
- 系統內的資料
未必能夠挽回
- 已寄出的信件
- 已答覆客戶的內容
- 已付出的款項
越難回復的事,越應放在人員確認之後。
同仁自行使用聊天工具的風險
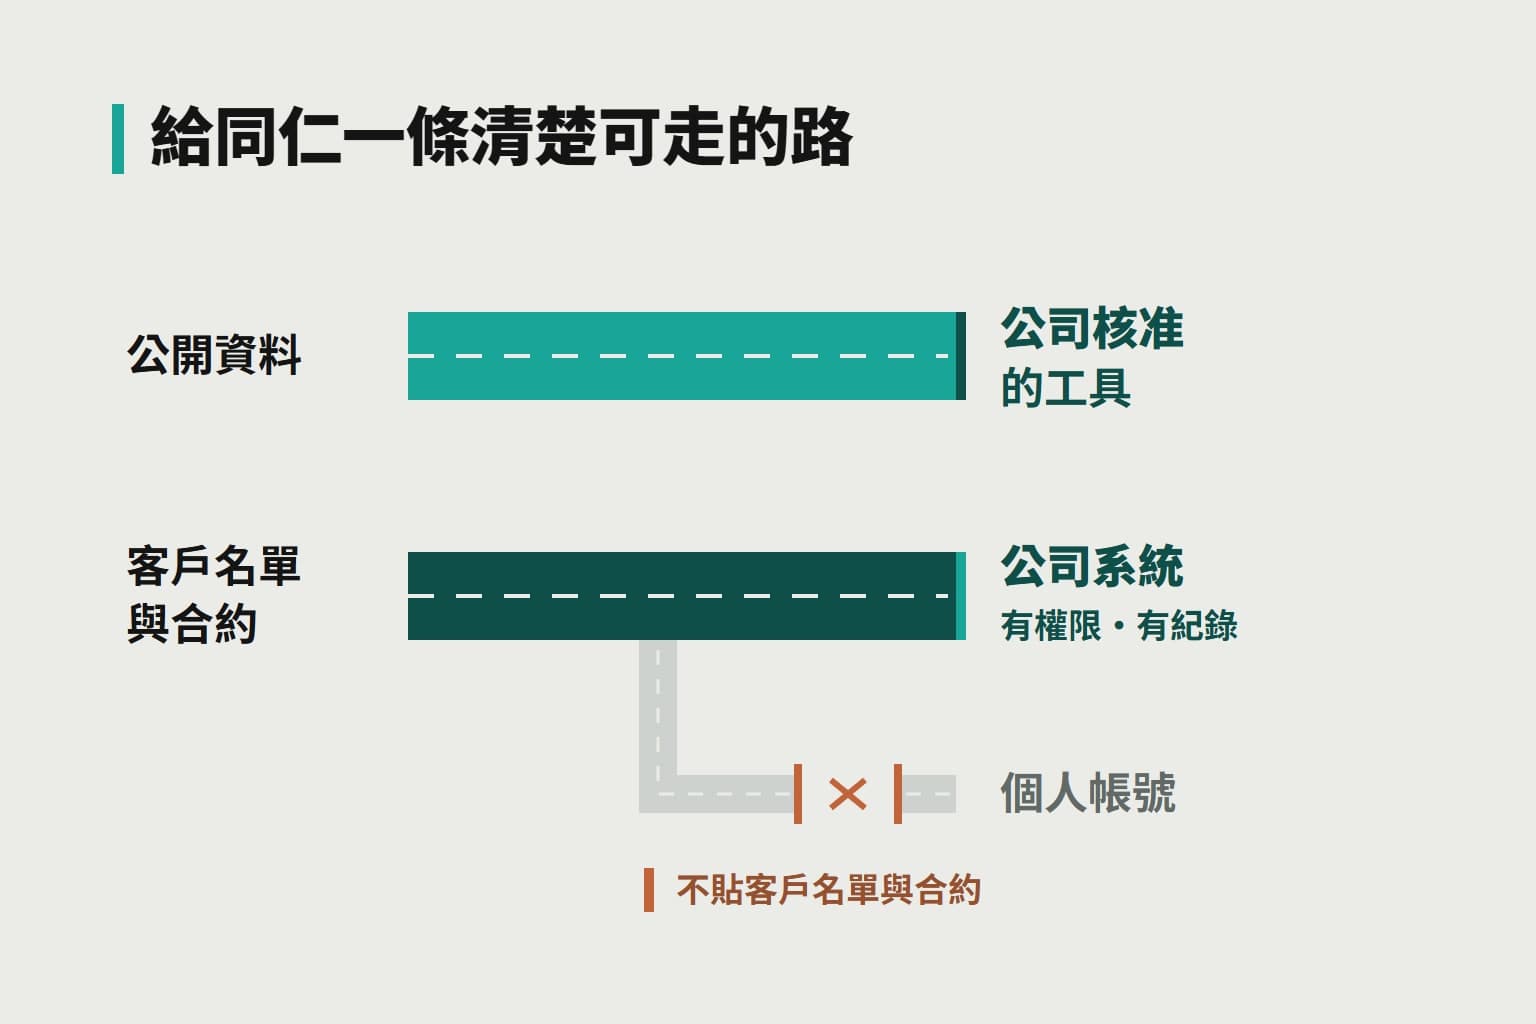
同仁使用免費或個人帳號時,資料可能依設定被用於改善模型,也可能在無意間貼上客戶名單或合約。單純禁止通常效果有限。比較實際的做法是訂定簡單規則、說明哪些資料不得貼上,提供公司核准的工具,並讓重要工作透過有權限與紀錄的系統進行。
對外 AI 的資料風險
對外的 AI 可能遭人以各種問法誘導。最重要的原則是:不希望客戶知道的資料,就不要放進接待 AI 的知識庫,例如成本、毛利、內部底價與其他客戶資料。此外,不應讓它單獨決定折扣或承諾,並定期檢視對話紀錄。
客戶個人資料的處理
本文不構成法律意見。實務上可以先確認幾個方向:只蒐集必要資料、告知客戶使用目的、設定處理權限、不再需要時予以刪除,並了解資料會傳到哪些服務商。醫療、金融等行業可能有額外規定,建議諮詢法律顧問。
畢克森不會將客戶資料用於其他用途。保密範圍與合作結束後的資料處理方式,建議在合約中明確約定。本網站的資料處理方式請參閱隱私權政策。
延伸閱讀
本文為一般性說明,不構成法律、稅務或財務建議。實際時程、費用與成效依各公司情況及書面約定為準。